Domain promistar.de kaufen?
Wir ziehen mit dem Projekt
promistar.de um.
Sind Sie am Kauf der Domain
promistar.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain promistar.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **

Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Hauswasserstation JUDO PROMI-QUICK CONTROL JPM-QC 2" 8150108Hauswasserstation JPM QC 1 mit Ein-Schrauben-Anschlusstechnik und prophylaktischem Keimschutz nach DIN EN 13959 DIN EN 13443 1 DIN 19628 und DIN EN 1567 zur DVGW Prüfung angemeldet für Wasser bis 30 Grad C Zur Druckregelung und Filtration von feinkörnigen und festen Verunreinigungen im Wasser, die als Belüftungselemente Korrosionen in wasserführenden Rohrleitungen auslösen und zu Funktionsstörungen an Kontroll- und Regelorganen führen können Mit Memo- Elektronik, die an den nächsten Rückspülvorgang durch einen Piepston in einem zweimonatigen Intervall erinnert Ausführung: Filtergehäuse aus hochwertigem Kunststoff PN 16 Einbaudrehflansch mit patentiertem Bajonettanschluss aus Messing mit Verschraubung (Gewindeanschluss nach DIN EN 10226 1) Ein-Schrauben-Anschlusstechnik waagerechter oder senkrechter Einbau möglich Filtergewebe aus Edelstahl silberbeschichtet zum prophylaktischen Keimschutz großes Handrad (mit Memoelektronik) zur Rückspülung nach dem Punkt-Rotations-System bei gleichzeit1450,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Anerkennung, Fachbücher von Pascale JungDas Fachbuch "Anerkennung" von Pascale Jung bietet eine tiefgehende Analyse des Begriffs der Anerkennung im Kontext ökumenischer Gespräche. Es beleuchtet die Herausforderungen, die sich aus dem Vergleich von Lehrsätzen und Ämtern ergeben, und thematisiert die Gefahr, dass Beurteilungen schnell in Verurteilungen umschlagen können. Jung schlägt vor, dass eine wechselseitige Anerkennung, die über das blosse Verstehen hinausgeht, eine neue Perspektive eröffnen könnte. Durch die Auseinandersetzung mit der Theorie von Paul Ricoeur wird der Begriff der Anerkennung präzisiert und in den ökumenischen Diskurs integriert. Das Buch regt dazu an, die Angst vor dem Verlust des Eigenen zu überwinden und stattdessen die Dankbarkeit für das Gemeinsame zu fördern. Es ist ein wertvoller Beitrag zur Philosophie und Religion, der sowohl für Fachleute als auch für Interessierte von Bedeutung ist.45,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Judo Promi Hauswasserstation 8167603 1", 100 my MaschenweiteJudo Promi Hauswasserstation 8167603Kombination aus Hauswasserstation und Mikroleckagenschutzsystemmit Edelstahl FiltergewebeDruckmindererRuckflussverhinderer und hochwirksamen Punkt Rotations Systemschützt vor den Folgen von Leitungswasserschaden und erkennt schleichende Wasserverlustewaagerechter oder senkrechter Einbau durch drehen des JUDO QUICKSET-E Einbau-Drehflanschesfür Trinkwasser bis 30° CBetriebsdruck 15 bar - 16 bar1275,62 €*Versand: 9,79 €Sichere Weiterleitung zum Anbieter
-
Hauswasserstation JUDO PROMI-QUICK CONTROL JPM-QC 2" 8150108Hauswasserstation JPM QC 1 mit Ein-Schrauben-Anschlusstechnik und prophylaktischem Keimschutz nach DIN EN 13959 DIN EN 13443 1 DIN 19628 und DIN EN 1567 zur DVGW Prüfung angemeldet für Wasser bis 30 Grad C Zur Druckregelung und Filtration von feinkörnigen und festen Verunreinigungen im Wasser, die als Belüftungselemente Korrosionen in wasserführenden Rohrleitungen auslösen und zu Funktionsstörungen an Kontroll- und Regelorganen führen können Mit Memo- Elektronik, die an den nächsten Rückspülvorgang durch einen Piepston in einem zweimonatigen Intervall erinnert Ausführung: Filtergehäuse aus hochwertigem Kunststoff PN 16 Einbaudrehflansch mit patentiertem Bajonettanschluss aus Messing mit Verschraubung (Gewindeanschluss nach DIN EN 10226 1) Ein-Schrauben-Anschlusstechnik waagerechter oder senkrechter Einbau möglich Filtergewebe aus Edelstahl silberbeschichtet zum prophylaktischen Keimschutz großes Handrad (mit Memoelektronik) zur Rückspülung nach dem Punkt-Rotations-System bei gleichzeit1450,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
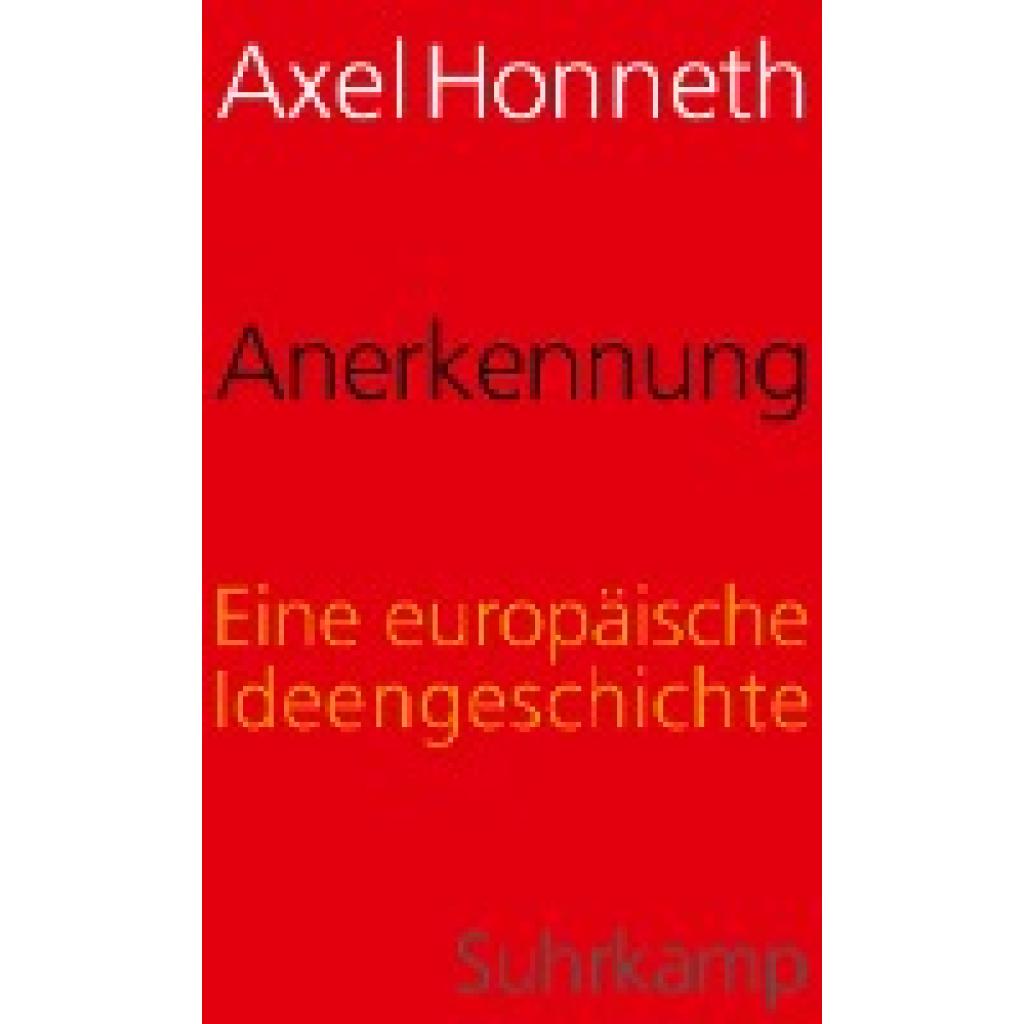
Honneth, Axel: AnerkennungAnerkennung , Eine europäische Ideengeschichte , Einarmwischer > Karosserie & Exterieur Styling , Erscheinungsjahr: 20180611, Produktform: Leinen, Autoren: Honneth, Axel, Seitenzahl/Blattzahl: 237, Keyword: Bestseller Bücher; Buch Bestseller; Respekt; Sachbuch-Bestenliste; Sachbuch-Bestseller-Liste; Sozialphilosophie; recognition; reconnaissance, Fachschema: Philosophie / Philosophiegeschichte~Philosophie / Gesellschaft, Politik, Staat, Fachkategorie: Soziale und politische Philosophie, Zeitraum: 1500 bis heute, Warengruppe: HC/Philosophie/20./21. Jahrhundert, Fachkategorie: Moderne Philosophie: nach 1800, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Suhrkamp Verlag AG, Verlag: Suhrkamp Verlag AG, Verlag: Suhrkamp, Länge: 203, Breite: 123, Höhe: 27, Gewicht: 363, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 172275728,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.